当我们说一个 Controller 慢的时候, 我们具体指的是什么?
依据官方文档中的定义:
In Kubernetes, controllers are control loops that watch the state of your cluster, then make or request changes where needed. Each controller tries to move the current cluster state closer to the desired state.
所以我们说的 Controller 慢, 指的应当是当期望状态变更后, Controller 将实际状态变为期望状态的时间慢, 而这中间涉及了较多的流程
从工作流说起
一个典型的基于 client-go 的 Controller 工作流如下: (经典老番)
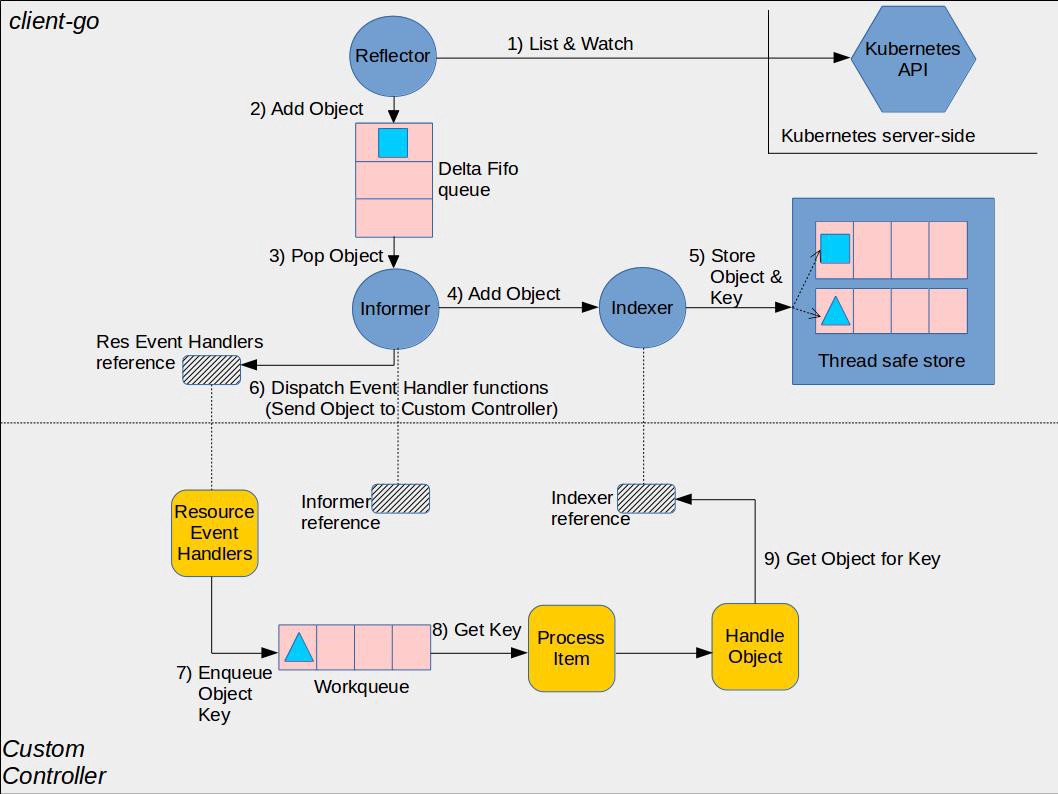
List & Watch
先来注意上面工作流中的第一步: List & Watch
缓慢的 List
List 是一个较重的操作, 我们先不考虑 List 对象带来的大量 ADD 事件, 仅关注 List 操作本身. List 操作会附带参数 resourceVersion=0 以获取 kube-apiserver 的缓存数据, 但即使是缓存数据, 请求的大量对象依然会导致 List 请求延迟较高, 在较大的集群中很可能超过 10s (Watch-List 会显著降低该延迟).
Controller 的部署大多是单主多实例模式, 在这种部署模式下 List 的操作耗时影响不大, 因为非 Leader 实例即使没有成为 Leader, 也会在启动后进行 List & Watch, 当成为 Leader 后才会注册EventHandler 进行事件处理, 所以 List 操作本身耗时较高, 但一般不会对 Controller 性能产生较大影响
难以监控的 Watch
没有直接的指标显示 Watch 的性能, 如果排查最后真的发现 Watch 有明显延迟, 一般来说需要关注以下指标:
- kube-apiserver cpu, mem等性能指标
- kube-apiserver 到 client 之间的网络质量和带宽占用
- ETCD 的相关指标
ResourceEventHandler 性能
Controller 可能需要实现 EventHandler 接口以处理特定资源的 ADD, UPDATE 和 DELETE 事件, 大部分 EventHandler 的实现出于性能考虑基本上是(也应该是)纯内存操作, 因为我们要保证事件处理分发到 Workqueue 的效率.
举一个 EventHandler 性能不好的例子, Kubernetes 的 Endpoint Controller 的 Pod EventHandler 性能就较差, 因为当一个 Pod 事件到达后, 其会遍历 Pod 当前 Namespace 下的所有 Service 以找到管理该 Pod 的 Service. 当一个 Namespace 下的 Pod 和 Service 数量都很多时, 该 EventHandler 的性能将会变得很差(特别是大量事件涌入时), 从而影响后续的处理流程
Reconcile 性能
Controller 处理对象事件的函数一般叫 Reconcile (当然, 叫啥名也都可以), 对应工作流的 HandleObject 部分. 该部分的性能指标比较容易获得, 性能瓶颈也比较容易确认. Reconcile 中基本上都通过 informer index 获取 K8s 对象, 我们更应关注的是外部调用和对 K8s 更新/删除请求的耗时
Reconcile 从 Workqueue 中获取 Key 并处理, Workqueue 保证了同一 Key 在同一个时间只会被一个 Goroutine 处理, 所以我们可以酌情扩大 Reconcile 的 Concurrency, 以达到提升 Controller 性能的目的
避免使用 Resync
Resync 指的是 Informer 从 Indexer 缓存中同步一次数据到 Delta FIFO 队列的动作, Resync 不是 Relist, 不会对 kube-apiserver 进行 list 操作, 仅仅是让缓存中的数据得到一次定时重新执行的机会
个人认为 Resync 这个动作意义不大, 能想到的用处有二:
- 防止 Controller 里面的某些代码 bug 导致事件漏处理; 但是 Controller 一般会使用错误重试队列, 如果是代码 bug 的话, 即使
Resync也无太大意义 - 周期性的和外部系统进行同步; 比如我们通过 Controller 将 K8s 中的资源数据同步到外部系统上, 但是外部系统的用户直接修改了外部系统上的数据,
Resync就给了一个周期性全量同步的机会
Resync 过程中缓存的全量数据都会触发一次 OnUpdate 处理逻辑, 很容易导致短时间的处理队列堆积, 机器负载增加等后果
综上所述, Resync 这个功能, 非必要不建议开启
成吨的 ADD 事件
Resync 带来的全量 UPDATE 事件我们可以避免, 但是 List-Watch 中 List 带来的全量 ADD 事件则是 Controller 避免不了需要处理的. 需要处理的数据量级很大时, 成吨的 ADD 事件可能会导致在 List 完成后较长一段时间最新的事件得不到即时处理
我们可以关注 Controller 重启后 (或者是其他触发 List 的场景) Workqueue 新增 Key 的数量以及堆积情况来判断处理初始 ADD 事件的时长, 并通过提升 Controller 的性能进行优化
事实上有方案对 ADD 事件进行过滤以达到快速启动的需求, 但是无一例外的需要引入额外的复杂性, 需要我们根据业务场景做选择
关注 Controller 单机瓶颈
Controller 一般以单主多实例模式部署, 也就是说, 只有一个实例上的 Controller 进程在真正工作. 通常来说, 实现良好的 Controller 即使只有一个实例在运行也能满足集群的同步需求. 如果确实有横向扩展的需求, 可以参考 KubeVela 的 Controller Sharding 架构.